In un precedente articolo abbiamo descritto le caratteristiche dei sistemi tradizionali di ricerca delle informazioni. Nei sistemi tradizionali la ricerca viene effettuata su insiemi limitati di documenti generalmente non collegati fra loro. In questo articolo studieremo i sistemi di ricerca di informazioni basati sul web, che costituisce la collezione di documenti collegati fra loro più vasta della storia, e presenta delle problematiche molto diverse dai sistemi tradizionali.
1) La ricerca di documenti sul web
Il web può essere considerato come una gigantesca collezione di documenti (ipertesti) collegati tra loro mediante collegamenti ipertestuali (in inglese hyperlink). Un documento è un contenitore di informazioni, che possono essere rappresentate tramite testi di varie lingue, immagini, audio, video.
La quantità di documenti presenti sul web ha raggiunto delle dimensioni enormi. Tuttavia questa grande biblioteca distribuita in centinaia di milioni di siti web è inutile, se non si hanno strumenti di ricerca efficienti, in grado di estrarre le informazioni che interessano da questa massa di dati.
Un motore di ricerca su web è un servizio online che serve per rispondere alle richieste di ricerca di informazioni effettuate dagli utenti tramite delle queries. Una query è costituita da un insieme di parole chiave (keywords) con le quali l’utente descrive il tipo di informazioni che intende estrarre dal web. Scopo del motore di ricerca è trovare sul web le informazioni associate al tipo di richiesta e presentare all’utente una lista di siti web, ordinata secondo dei criteri di rilevanza e importanza.
L’utilizzo delle funzioni del web è diventato alla portata di tutti e si basa su una semplice architettura client-server.
- Il client (normalmente un web browser) comunica con il server mediante il protocollo HTTP (hypertext transfer protocol), un protocollo semplice e asincrono.
- Il client invia una richiesta al server specificando un URL (uniform resource locator) come ad esempio https://www.amazon.it.
- Il server esamina la richiesta, legge i dati richiesti e invia la risposta al client.
- I dati trasmessi fra il client e il server possono essere di vari tipi (testi, immagini, video, audio, etc.).
- La struttura e il contenuto delle pagine web sono codificati con il linguaggio standard HTML (hypertext markup language).
La ricerca di documenti sul web ha delle caratteristiche specifiche, da renderla molto diversa dai sistemi di ricerca tradizionali.
- I documenti sono scritti in linguaggi diversi e hanno formati diversi.
- Le dimensioni variano da documenti brevi a documenti molto lunghi.
- I documenti sono strutturati nel linguaggio HTML e spesso esistono molte copie e/o versioni di un documento.
- I documenti sono in genere connessi tra loro tramite hyperlink.
- L’interfaccia è semplice; gli utenti sono in genere non esperti e fanno ricerche con poche parole chiave.
- Il risultato di una ricerca contiene in genere molte pagine e l’elenco viene ordinato secondo criteri di rilevanza specifici.
- La rilevanza e l’autorità di un documento dipendono non solo dal contenuto del documento, ma anche dal sito web sul quale è memorizzato e dai collegamenti con altri siti.
Per questi motivi le tecniche di ricerca tradizionali, pur essendo in parte utili e necessarie anche per la ricerca sul web, non sono sufficienti.
I motori di ricerca sul web utilizzano programmi specializzati chiamati crawler o spider, per accedere ai contenuti delle pagine web, salvarne una copia testuale e infine creare un indice su cui poter effettuare la ricerca e visualizzazione. Gli indici permettono di fornire risultati in tempi brevissimi, nonostante il numero enorme di siti web presenti oggi nella rete Internet.
Alcuni dei motori di ricerca più diffusi sono i seguenti:
- Google – il motore di ricerca attualmente più utilizzato
- Bing – motore di proprietà della Microsoft
- Yandex – motore di ricerca russo
- Baidu – motore di ricerca cinese
Dal punto di vista matematico il web può essere considerato come un grafo orientato, i cui nodi sono le pagine HTML, e ogni hyperlink è un arco orientato che collega due nodi. Si chiamano in-link o backlink i collegamenti in entrata da altri siti web che sono diretti su una pagina di un dato sito. I collegamenti in uscita che escono da una pagina di un sito verso una pagina di un altro sito si chiamano out-link.
Il grafo è debolmente connesso, nel senso che molte coppie di pagine non hanno hyperlink che le collegano.
Per maggiori dettagli sulla teoria dei grafi e sulla struttura del web si può vedere questo articolo.
In questo articolo descriveremo i motori di ricerca generali basati sui crawler, chiamati anche motori di ricerca orizzontali. Ricordiamo che esistono anche altri tipi di motori di ricerca sul web. Tra questi in particolare:
- motori di ricerca verticali – sono specializzati su uno specifico ambito di conoscenza, come turismo, ricerca personale, ecc.;
- web directory – permettono di cercare i siti web migliori per una data categoria. Non cercano contenuti informativi ma forniscono informazioni sulle sorgenti di informazioni.
Alcuni esempi di motori di ricerca verticali interessanti sono i seguenti.
Linkedln: motore di ricerca specializzato sul mondo del lavoro e professionale.
TinEye: motore di ricerca di immagini inversa. Anche Google Immagini permette la ricerca di immagini inversa. Invece delle parole chiavi testuali, nella ricerca di immagini inversa si da in input una immagine e il motore cerca immagini simili sul web.
Skyscanner: un motore di ricerca per i viaggi aerei.
TripAdvisor: per ricerca di hotel e altre informazioni sui viaggi.
Amazon: permette di cercare ed acquistare prodotti da venditori di tutti i paesi del mondo.
2) Struttura di un motore di ricerca sul web
Lo scopo di un motore di ricerca è dare una risposta veloce e il più possibile esaustiva ad una richiesta fatta tramite una query. I due principali parametri che misurano le prestazioni di un motore di ricerca sono quindi i seguenti:
- efficacia: il motore deve essere in grado di estrarre i documenti che hanno maggiore rilevanza rispetto alla richiesta;
- efficienza: il tempo di risposta deve essere più breve possibile.
I principali processi e componenti di un motore di ricerca sono illustrati nel seguente diagramma:
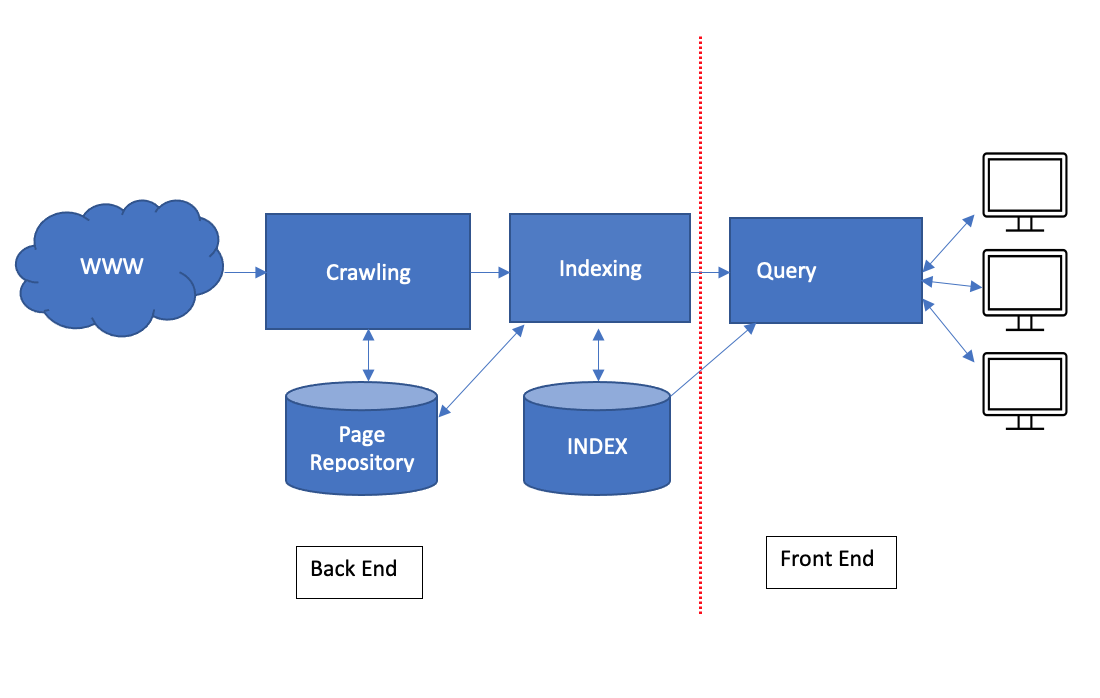
- Crawling: il crawling è un processo mediante il quale i motori di ricerca esplorano il web, per analizzare il contenuto delle pagine e dei collegamenti, tenendo conto anche delle modifiche e delle cancellazioni.
- Database delle pagine (page repository): le pagine trovate dai crawler vengono temporaneamente memorizzate nel database della pagine. Successivamente vengono elaborate dal processo di indicizzazione, nel quale vengono estratte le informazioni più importanti contenute nelle pagine.
- Indexing (creazione dell’indice): i dati acquisiti dal modulo crawler vengono elaborati e vengono creati degli indici enormi, che sono fondamentali nel processo di ricerca.
- Query: questo processo comprende l’interfaccia utente, la ricerca, il ranking, e la valutazione.
- Displaying: è il processo finale di visualizzazione del risultato, sul dispositivo utilizzato per la query.
Nei prossimi paragrafi vedremo in dettaglio le funzioni svolte dai vari processi di un motore di ricerca web.
3) Il processo di crawling
Scopo del processo di crawling è l’estrazione delle pagine presenti sui siti web, e la creazione di un database delle pagine, che verrà utilizzato dal successivo processo di indicizzazione.
L’obiettivo è estrarre in modo efficiente un numero elevato di pagine web, insieme alla struttura dei collegamenti che le collegano fra loro. Il processo di crawling si svolge dietro le quinte (backend), mediante programmi specializzati che sono noti con diversi nomi: crawler, bot, spider. Questi programmi operano in modo automatico e indipendente dall’intervento esterno.
La complessità del processo di crawling deriva dalle caratteristiche del web, tra le quali le più importanti sono:
- il volume enorme del web
- l’alta velocità di aggiornamento delle pagine
- la generazione dinamica del pagine
Il numero delle pagine presenti sul web ormai è dell’ordine di centinaia di miliardi di pagine. Questo numero è in continua evoluzione: alcune pagine vengono cancellate, mentre altre vengono aggiunte.
La generazione automatica riguarda ad esempio le pagine dei siti di notizie o siti di e-commerce, in cui vengono aggiunti nuovi contenuti con frequenza molto alta. L’alta frequenza dei cambiamenti sul web implica che il crawler riesce appena a completare lo scarico delle pagine da un sito web, mentre nuove pagine vengono aggiunte e altre vengono cancellate.
3.1) Architettura del web crawler
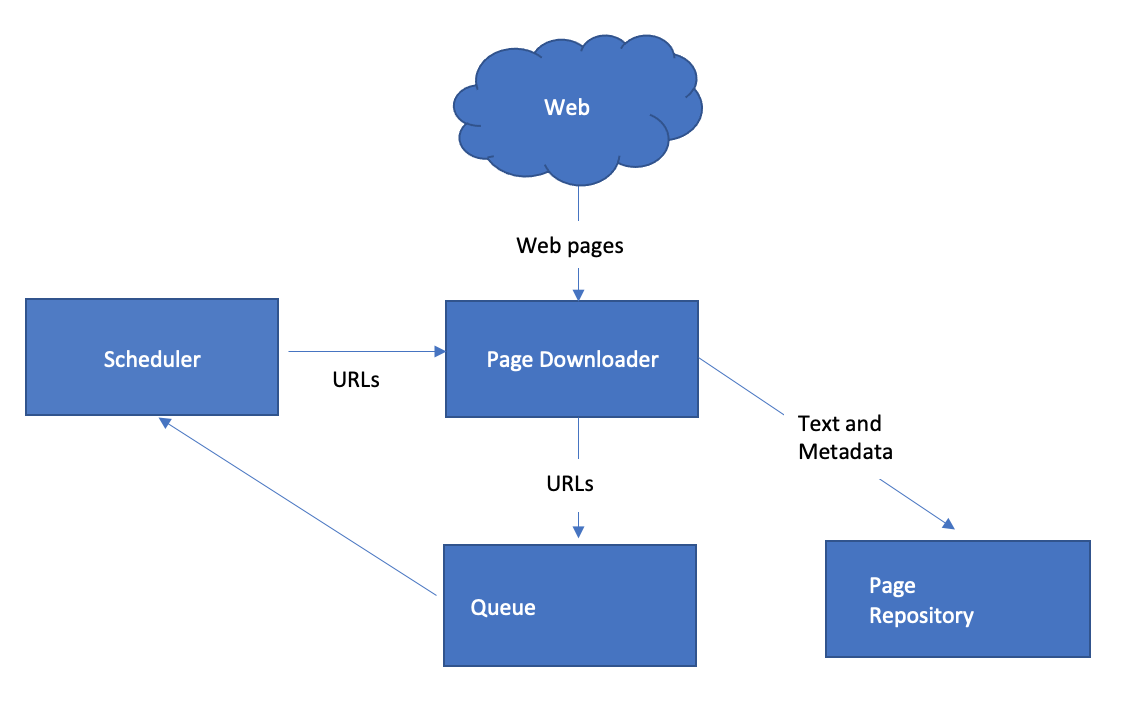
L’architettura di un web crawler è composta di tre componenti principali:
- la frontiera del crawler
- il downloader delle pagine
- il database della pagine (page repository)
La frontiera del crawler
Il programma crawler inizia l’esecuzione elaborando una lista di URL già preparata, che contiene indirizzi di siti importanti che hanno molti collegamenti con altri siti web. Questa lista viene chiamata la frontiera del crawler. La frontiera del crawler comprende quindi i siti web che devono essere visitati ed esplorati.
Semplificando, il crawler legge un URL dalla frontiera e esplora tutte le pagine presenti in quel sito. In ogni pagina identifica eventuali collegamenti (hyperlink) che puntano ad altre pagine di altri siti. Se si tratta di nuovi collegamenti allora vengono aggiunti nella frontiera alla lista dei siti da visitare.
Gli URL della frontiera possono essere visitati più volte per identificare eventuali aggiornamenti.
Il downloader delle pagine
Questo programma legge le pagine web dagli URL presenti nella frontiera del crawler e effettua una analisi del contenuto.
Un problema che i crawler devono affrontare è la risoluzione del DNS (Domain Name System). Come è noto ogni server connesso a Internet è identificato da un unico indirizzo IP (Internet Protocol Address), rappresentato da \(4\) gruppi di interi separati da punti, ad esempio \(192.125.35.58\). Un server DNS è un computer con un database che contiene tutte le coppie di indirizzi IP e dei nomi simbolici dei siti web, in modo simile ad un elenco telefonico.
Si chiama risoluzione del DNS il processo mediante il quale un dato URL, ad esempio www.amazon.com, viene tradotto nel suo indirizzo IP. Per effettuare questa traduzione il crawler deve contattare un server DNS, il quale ritorna come risultato l’indirizzo IP.
Il processo di risoluzione del DNS rappresenta un collo di bottiglia importante nel processo di crawling.
Il database delle pagine (page repository)
Le pagine estratte vengono memorizzate in forma completa temporaneamente nel database delle pagine. Normalmente le pagine restano nel repository fino a che vengono elaborate nel successivo processo di indicizzazione, nel quale viene creato un indice in cui vengono registrate tutte le informazioni considerate rilevanti per ogni pagina. Nell’indice vengono memorizzate solo alcune informazioni che verranno usate come chiavi di ricerca.
In fase di ricerca il motore legge il fine indice, rendendo possibile una risposta quasi immediata alle richieste degli utenti web.
Per migliorare le prestazioni, le pagine che vengono accedute con maggiore frequenza possono rimanere per tempi più lunghi nel database delle pagine.
3.2) Frequenza del crawling
Il web è un ambiente altamente dinamico e in continua espansione. Ogni giorno molte pagine vengono aggiunte, mentre altro sono modificate o cancellate. Quindi il contenuto informativo presente sul web non è stabile. Un obiettivo dei motori di ricerca è naturalmente riuscire ad estrarre dei contenuti il più possibile aggiornati. Per questo il processo di crawling è un processo continuo, che sostanzialmente non si ferma mai.
4) Il processo di indicizzazione (indexing)
Come abbiamo visto la funzione fondamentale del processo di crawling consiste nel creare un database contenente le informazioni sulle pagine estratte e sui collegamenti fra di esse. La funzione del processo di indicizzazione è di organizzare e memorizzare le informazioni rilevanti delle pagine, presenti nel titolo, nella descrizione e nel testo, in modo tale che le informazioni possano essere ricercate in modo efficiente. Invece di memorizzare in modo integrale il contenuto della pagina, si crea una rappresentazione sintetica di ogni documento, che contiene l’informazione ritenuta rilevante per la ricerca.
Quando effettuiamo una query, ad esempio tramite Google, il motore di ricerca non legge il contenuto dei miliardi di pagine presenti sul web, ma analizza il database indice preparato in precedenza nel processo di indicizzazione. In questo modo si riesce a rispondere alle query in modo efficiente.
In genere viene creato un indice invertito (inverted index), che ad ogni parola individuale associa un elenco di documenti in cui tale parola è presente. L’indice creato si può paragonare all’indice presente alla fine di un libro. Per trovare in quale parte del libro si trova un particolare argomento, non è necessario leggere tutto il libro dall’inizio alla fine, ma è sufficiente leggere l’indice.
4.1) Indicizzazione distribuita e dinamica
Le dimensioni del web hanno ormai raggiunto valori enormi, con decine di miliardi di pagine. Il processo di indicizzazione di questa gigantesca mole di documenti non può essere effettuato in modo efficiente su un singolo computer, ma deve essere distribuito su gruppi di computer (cluster) che contengono centinaia di macchine. L’indice complessivo è quindi creato e suddiviso in diverse macchine secondo opportuni criteri. Due criteri principali di suddivisione sono i seguenti:
- indice suddiviso per termine o parola chiave
- indice suddiviso per documento
Come il crawling, anche il processo di indicizzazione è un processo continuo, sempre attivo. Un numero molto grande di documenti viene continuamente aggiornato, aggiunto o cancellato, e nuove parole chiave vengono aggiunte o aggiornate, mentre altre vengono eliminate. È necessario quindi mantenere sempre aggiornato l’indice del motore di ricerca, altrimenti l’informazione sull’indice non sarebbe più allineata con il contenuto effettivo dei documenti presenti sul web.
Se il numero dei cambiamenti fosse limitato e non troppo frequente si potrebbe effettuare una ricostruzione periodica dell’indice complessivo.
Tuttavia questo approccio è poco efficiente per i motori di ricerca sul web, date le dimensioni e la frequenza degli aggiornamenti. Una soluzione migliore consiste nel gestire due indici: l’indice principale e un indice secondario in cui si memorizzano le informazioni relative agli aggiornamenti delle pagine web. Questo indice ausiliario è di dimensioni ridotte e quindi può essere caricato nella memoria principale dei computer. Quando si effettua una ricerca si devono estrarre informazioni leggendo sia l’indice principale sia l’indice secondario. Periodicamente, quando l’indice secondario raggiunge dimensioni rilevanti, può essere effettuata la fusione dei due indici.
4.2) Indicizzazione audio, immagini e video
Gran parte delle informazioni contenute sul web è relativa a documenti testuali. Tuttavia come abbiamo accennato in precedenza i motori di ricerca sono in grado anche di estrarre immagini e video. In questi casi il risultato di una ricerca può consistere ad esempio in un elenco di immagini, ognuna delle quali è contenuta in una pagina di un sito web. Cliccando su una immagine si viene indirizzati alla pagina web che la contiene.
Per gestire questo tipo di ricerche è naturalmente necessario estrarre le informazioni principali che individuano una immagine o un video.
Il metodo di indicizzazione delle immagini e dei video è sostanzialmente simile nei due casi. In primo luogo si estraggono informazioni come il titolo o la descrizione dell’immagine, e altre informazioni ausiliarie (metadati) associate all’immagine. A queste si aggiungono anche parole contenute nel testo del pagina in cui si trova l’oggetto, assumendo che le parole del testo descrivano l’oggetto. Inoltre mediante algoritmi sofisticati si cerca di analizzare e descrivere il contenuto delle immagini o dei video.
Chiaramente l’indicizzazione di una immagine o di un video è un processo molto più complesso dell’indicizzazione di un testo, e quindi il livello di qualità dei risultati delle ricerche è inferiore.
5) Il modulo query e l’interfaccia utente
Il processo di query è un processo frontend che viene iniziato nel momento in cui un utente invia una query. Il programma di query converte la richiesta fatta dall’utente dal linguaggio naturale al linguaggio che il motore di ricerca è in grado di comprendere. Quindi viene effettuata la ricerca consultando l’indice e il repository delle pagine. L’indice inverso permette di individuare gli indirizzi delle pagine web sui quali sono presenti le parole chiave contenute nella query. Le pagine estratte, che si chiamano pagine rilevanti, vengono quindi passate al programma di ranking.
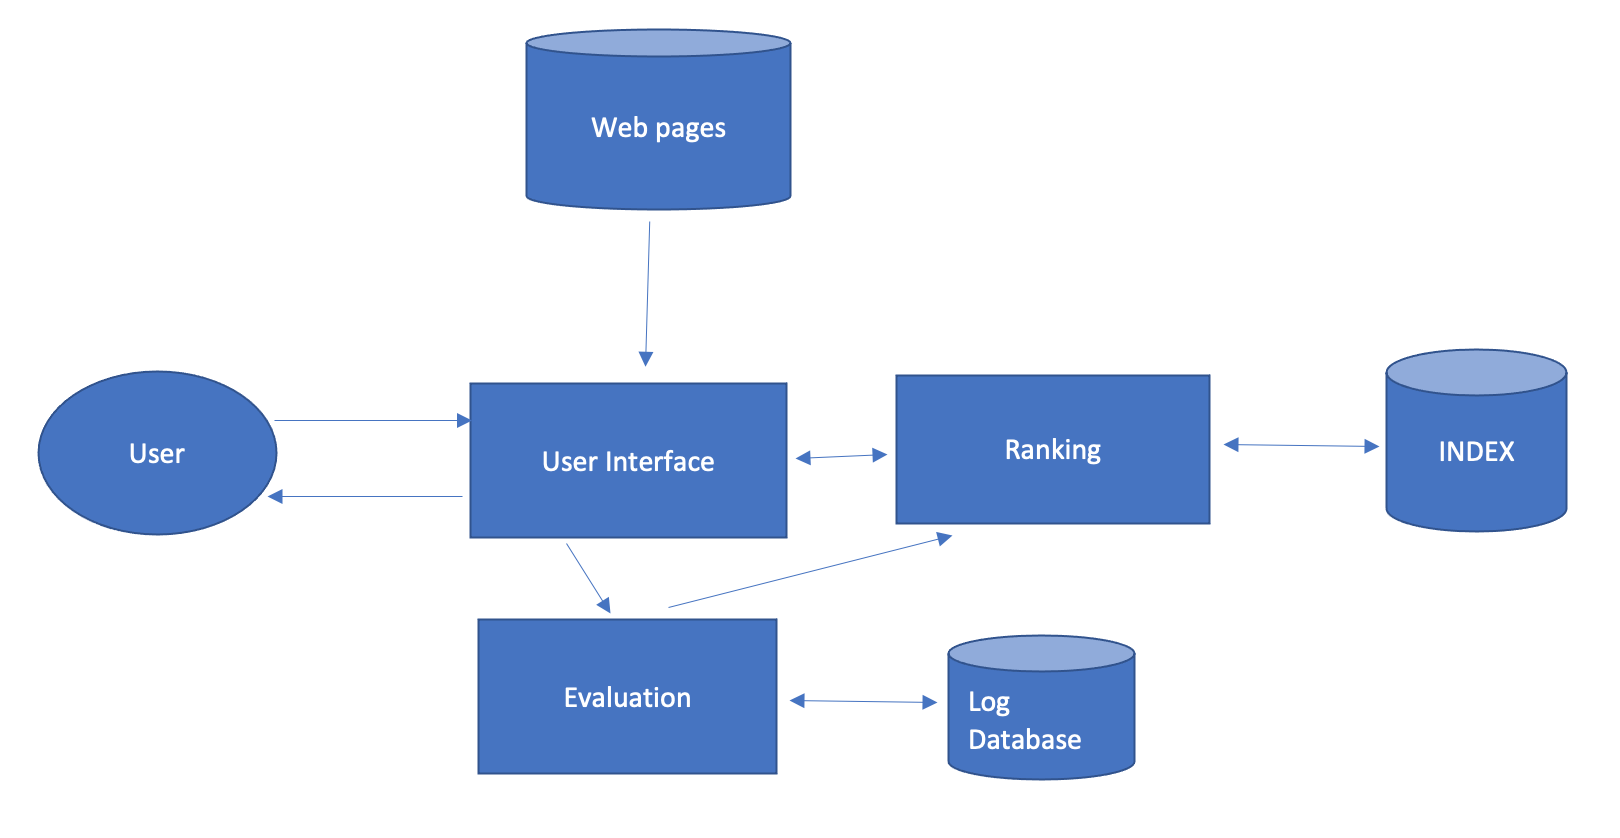
Il processo di query comprende tre programmi principali:
- interfaccia utente
- ranking
- valutazione della ricerca
5.1) Interfaccia utente
L’interfaccia utente permette all’utente di inserire le sue query e di visualizzare l’elenco dei risultati della richiesta. L’utente scrive la sua richiesta nella casella dell’interfaccia grafica e il motore fornisce una lista di risultati, ordinata secondo un criterio di rilevanza definito nell’algoritmo. Un buon motore di ricerca deve permettere la possibilità di scrivere frasi, operatori logici e altre opzioni. Inoltre deve essere in grado di adattare e presentare i risultati di una ricerca sui differenti dispositivi che possono esser utilizzati dagli utenti: personal computer, notebook, smartphone, ecc.
L’interfaccia dei motori di ricerca ha subito un processo di evoluzione importante negli ultimi anni in vari aspetti, tra cui contenuto, modalità di presentazione, modalità di navigazione.
Un aspetto particolare è l’utilizzo sempre più importante dei metodi che fanno uso dell’intelligenza artificiale (AI) nei processi di estrazione delle informazioni. L’AI viene utilizzata in particolare nel ranking delle pagine, effettuato in base a rilevanza, popolarità, numero di backlink. Possono inoltre essere utilizzate informazioni di profilo dell’utente e la cronologia delle sue ricerche precedenti. Questo permette ai motori di ricerca di personalizzare la ricerca e i risultati in base alle preferenze dei singoli utenti.
In teoria questo dovrebbe produrre dei risultati maggiormente soddisfacenti. Tuttavia non bisogna sopravvalutare l’importanza dell’AI. Il problema fondamentale è che si devono comprendere le reali intenzioni dell’utente che effettua una query. Si tratta di un compito molto complesso e difficile anche per il cervello umano, e a maggior ragione per i programmi di AI, per quanto siano sofisticati. Quindi pur avendo in generale degli indubbi vantaggi, l’utilizzo dell’AI nei motori di ricerca, se non ben gestito, può portare in certi casi a risultati non corretti e di poca qualità.
5.2) Modulo ranking delle pagine web
Il modulo di ranking legge l’insieme delle pagine estratte dal modulo di query e ordina le pagine secondo dei criteri di rilevanza definiti in precedenza. Lo scopo dell’ordinamento è quello di presentare all’inizio le pagine che probabilmente hanno un interesse maggiore per l’utente che ha fatto la richiesta. I criteri con cui vengono stabilite le regole di ordinamento possono essere molteplici e diverse a seconda del motore di ricerca. Due criteri fondamentali sono i seguenti.
- Presenza delle parole chiave utilizzate nella query nel titolo o nella descrizione della pagina, piuttosto che nel corpo della pagina. In generale si può assumere che un documento in cui una parola chiave appare all’inizio sia più rilevante di un documento in cui la parola appare nelle parte finale.
- Indice di popolarità della pagina, calcolato in base alla struttura dei collegamenti presenti nella pagina.
Ad ogni pagina viene assegnato un punteggio in base a questi criteri. Quindi viene presentato all’utente l’elenco delle pagine ordinato mettendo all’inizio quelle con punteggio più alto.
5.3) Valutazione dei risultati estratti
Per migliorare i motori di ricerca è importante riuscire a determinare il livello di soddisfazione degli utenti che effettuano ricerche sul web. La valutazione è un processo automatico che serve per valutare l’efficacia e l’efficienza delle risposte data alle query. A questo scopo sono utili i vari archivi di registrazione (log) che contengono traccia delle ricerche effettuate e registrano le azioni degli utenti. Alcuni dati importanti per capire il comportamento degli utenti sono i seguenti:
- numero di click sull’elenco delle pagine
- tempo di navigazione su un sito web
- numero di pagine visitate su un sito web
- tempo di uscita dall’elenco dei risultati della ricerca
L’obiettivo del processo di valutazione è utilizzare i risultati delle ricerche per eventualmente migliorare anche le ricerche future e riuscire a dare all’utente le migliori risposte possibili.
6) L’algoritmo PageRank di Google
PageRank è l’algoritmo utilizzato da Google per gestire il ranking delle pagine. È stato inizialmente sviluppato nel \(1996\) dai fondatori Larry Page e Sergey Brin.
Le pagine estratte da una query in genere non hanno la stessa importanza o rilevanza. L’algoritmo PageRank cerca di dare una valutazione numerica all’importanza di ognuna delle pagine estratte.
Come abbiamo visto la struttura del web può essere rappresentata tramite un grafo orientato, nel quale le pagine, cioè i vertici del grafo, sono collegate fra loro tramite collegamenti (hyperlink), che sono archi orientati che collegano due pagine. PageRank assegna un valore numerico ad ogni collegamento. Un criterio fondamentale per determinare il valore di una pagina è dato dal numero e dalla qualità dei collegamenti, che indirizzano la pagina a pagine di altri siti web. Maggiore è il numero dei link complessivi da altri siti, maggiore è il valore assegnato dall’algoritmo PageRank. Poiché il web è in continuo aggiornamento e ampliamento anche il grafo del web deve essere continuamente aggiornato.
Esempio 5.1
Supponiamo di avere un web con \(4\) pagine, come illustrato nella figura seguente.

All’inizio il valore che viene trasferito da un pagina ad un’altra viene diviso in modo uniforme fra tutti i collegamenti in uscita dalla pagina.
È utile anche la rappresentazione matriciale del grafo:
Gli elementi non nulli della riga \(i \text{-esima}\) corrispondono ai link in uscita (out-link) della pagina \(P_{i}\), mentre gli elementi non nulli della colonna \(i \text{-esima}\) corrispondono ai link in ingresso (in-link) nella pagina \(P_{i}\).
Come funziona l’algoritmo PageRank
Indichiamo con \(r(P)\) il valore di ranking assegnato ad una pagina \(P\). La formula per il calcolo del valore è la seguente:
La somma viene effettuata su tutte le pagine \(Q\) che puntano alla pagina \(P\).
Naturalmente per poter applicare la formula è necessario conoscere i valori \(r(Q)\), che inizialmente non sono conosciuti. Per questo l’algoritmo PageRank applica la seguente procedura iterativa. Supponiamo di avere un web con \(n\) pagine \(\{P_{1},P_{2},\cdots,P_{n}\}\). Definiamo il vettore colonna iniziale \(v_{0}\) con probabilità uniforme \(\dfrac{1}{n}\), cioè
Sia \(A=(a_{ij})\) la matrice che rappresenta il grafo del web. Quindi \(a_{ij}\) indica la probabilità che un utente passi dalla pagina \(i\) alla pagina \(j\). L’algoritmo PageRank consiste in una serie di moltiplicazioni tra vettori e matrici:
\[ \begin{array}{l} v_{1}= Av_{0} \\ v_{2}= Av_{1} =A^{2}v_{0} \\ \vdots \\ v_{n}=Av_{n-1}=A^{n}v_{0} \end{array} \]dove i vettori sono vettori colonna.
Sotto certe condizioni la successione dei vettori calcolati tende ad un valore di equilibrio, che viene chiamato il vettore PageRank del grafo del web.
Questo algoritmo di fatto coincide con un problema classico dell’algebra lineare, cioè calcolare gli autovalori e gli autovettori di una matrice quadrata. Ricordiamo che gli autovalori \(\lambda\) e gli autovettori \(x\) di una matrice \(A\) soddisfano l’equazione
In questo caso \(x\) viene chiamato autovettore di \(A\) e \(\lambda\) è l’autovalore corrispondente.
Quindi l’algoritmo PageRank è equivalente alla determinazione dell’autovettore \(v\) corrispondente all’autovalore \(1\).
Per approfondire i dettagli matematici dell’algoritmo PageRank vedere [1].
7) Motori di ricerca e SEO
I risultati ottenuti da un motore di ricerca in risposta ad una query vengono elencati in una pagina chiamata la SERP (Search Engine Report Page).
Si chiama ricerca organica l’insieme dei risultati presenti nella SERP ottenuti a fronte di una query senza servizi a pagamento.
Il posizionamento dei vari siti nella SERP è determinato dagli algoritmi di ricerca e dipende da fattori come la rilevanza, la qualità dei contenuti rispetto alla richiesta e l’autorità delle pagine web. Un parametro importante è il numero dei backlink che puntano una pagina.
Nella ricerca non organica invece i risultati che appaiono nella SERP derivano da annunci a pagamento sponsorizzati.
La SEO (Search Engine Optimization) è un insieme di procedure utilizzate per migliorare il proprio ranking nei motori di ricerca e quindi avere una posizione più alta nella SERP. L’obiettivo finale della SEO è aumentare il traffico e il numero dei clienti che accedono ad un sito web. Per poter applicare in modo efficace le procedure della SEO è fondamentale conoscere bene i complessi algoritmi dei motori di ricerca.
Alcuni fattori importanti sui quali agire per migliorare la qualità di un sito sono i seguenti.
- Collegamenti in entrata (in-link): si assume che i link da altri siti sono un indice della qualità e importanza dei contenuti delle pagine puntate. Quindi l’autorità di un sito dipende in modo importante dal numero di collegamenti in entrata al sito stesso. A maggior ragione se i collegamenti provengono da altri siti a loro volta molto importanti e autorevoli.
- Contenuto: i documenti dovrebbero avere alta qualità di contenuti e anche essere formalmente ben scritti e facili da capire. I motori di ricerca quindi cercano anche di analizzare il contenuto di una pagina, per verificare la rilevanza con la query e anche la correttezza formale e sintattica.
- Struttura delle pagine: le pagine sono scritte tramite il linguaggio standard HTML. È quindi importante dare una buona struttura ai documenti, inserendo parole chiave e altre voci nelle posizioni giuste, al fine di facilitare il lavoro di estrazione delle informazioni da parte dei crawler.
Esistono diversi strumenti software che possono aiutare nel lavoro di ottimizzazione dei siti web. Tra questi ad esempio:
- Google Search Console, per monitorare le prestazioni del sito nella ricerca Google
- Google Analytics, strumento più complesso che permette di analizzare il comportamento dei visitatori nell’interagire con il sito
- Bing Webmaster Tools, la versione per Microsoft Bing di Google Search Console
7.1) Limiti della SEO
Ci sono alcuni aspetti della SEO che vanno considerati attentamente. In primo luogo nessuno conosce veramente i dettagli degli algoritmi utilizzati da Google e dagli altri motori di ricerca. Inoltre questi algoritmi non sono immutabili, ma sono in continua e rapida evoluzione. Ad ogni aggiornamento le prestazioni del sito nella ricerca possono peggiorare, e così anche il posizionamento. Oltre a questi aspetti tecnici, la concorrenza in questo ambito è molto agguerrita e primeggiare nella ricerca non è assolutamente facile, specialmente per chi ha risorse limitate.
Anche il criterio di valutazione dell’autorità di un sito in base ai collegamenti esterni che puntano al sito stesso ha dei limiti. Per la qualità è necessario che i siti da cui provengono i collegamenti siano a loro volta importanti e abbiano contenuti correlati con il nostro sito web. Come è intuibile, questo aspetto risulta difficile da controllare.
Le procedure relative alla SEO hanno dei costi rilevanti, sia in termini economici che di tempo, con gli eventuali benefici che non sempre sono soddisfacenti e/o visibili nel breve o medio periodo. Non è detto quindi che ci sia un ritorno significativo dell’investimento. Senza rinunciare naturalmente ad alcune procedure di base della SEO, è bene essere consapevoli che il successo duraturo di un sito non dipende solo ed esclusivamente dalla SEO, ma soprattutto dalla qualità dei contenuti presenti sulle pagine del sito e dall’interesse che suscitano negli utenti.
8) Rischi legati all’utilizzo dei motori di ricerca
L’utilizzo dei motori di ricerca sul web è ormai una necessità imprescindibile in molte attività umane. Tuttavia bisogna essere consapevoli che presenta anche dei rischi, dovuti alla violazione della privacy e anche alla possibile manipolazione delle informazioni, utilizzata per controllare e indirizzare il comportamento delle persone.
8.1) Problemi di privacy
Le query immesse dagli utenti normalmente non vengono cancellate dopo aver completato la risposta, ma vengono memorizzate nei database dei motori di ricerca. Inoltre vengono registrate informazioni sugli utenti e sul tipo di contenuti ai quali sono interessati.
Da una parte queste informazioni hanno un valore positivo, in quanto permettono ai motori di ricerca di personalizzare i risultati in base ai profili degli utenti. In questo modo i risultati spesso sono adattati, evidenziando le informazioni che vengono ritenute più rilevanti per l’utente.
D’altra parte tuttavia queste informazioni possono essere utilizzate per invadere la privacy degli utenti. Anche soggetti terzi potrebbero accedere a queste informazioni e proporre pubblicità su prodotti e servizi, ai quali gli utenti potrebbero essere interessati. Si tratta di un fenomeno che, oltre ad invadere la privacy, può diventare molto invasivo e fastidioso.
Un modo per superare questi problemi, facendo le ricerche ad esempio con Google, è l’utilizzo di una rete privata virtuale (VPN), che crittografa i dati trasmessi sulla rete e impedisce di memorizzare informazioni personali.
Un altro modo sicuro per il rispetto della privacy è l’utilizzo di motori di ricerca che garantiscano l’anonimato. Un esempio di questo tipo è il motore DuckDuckGo, che non registra informazioni sugli utenti che eseguono le query. Un altro esempio rilevante è il motore Brave, che oltre a garantire l’anonimato utilizza propri database di indici, senza appoggiarsi agli indici utilizzati da altri motori, come Google e Bing.
8.2) Manipolazione delle informazioni
Bisogna essere consapevoli che i motori di ricerca oggi presenti non sono soggetti neutrali fra gli utenti e le informazioni presenti sul web. In generale appartengono a società private sulle quali non c’è alcun controllo degli stati e dei governi.
Gli algoritmi di estrazione e di ranking sono il risultato di scelte soggettive effettuate dagli sviluppatori dei programmi utilizzati dai motori di ricerca. Quindi bisognerebbe prendere i risultati delle query sempre con un certo grado di riserva.
Purtroppo gran parte degli utenti ha un approccio ingenuo e da per scontato che la qualità dei risultati ottenuti presentati nella SERP corrisponda al contenuto effettivo delle informazioni presenti sul web.
Questo atteggiamento fornisce agli sviluppatori dei motori di ricerca un grande potere per influenzare e orientare gli utenti. Si possono facilmente influenzare e orientare le scelte degli utenti in molteplici settori: economia, finanza, politica, istruzione, e così via.
Il problema è particolarmente grave in occasione di elezioni politiche. Gli algoritmi dei motori di ricerca possono essere modificati, in modo da fornire dei risultati che possano orientare le scelte degli utenti verso un candidato o un partito politico, stravolgendo una delle basi fondamentali della democrazia politica.
Il problema potrebbe essere alleviato se ci fossero diversi motori di ricerca in competizione fra loro, in modo che gli utenti possano scegliere in base alla qualità del servizio corrisposto. Purtroppo allo stato attuale c’è una situazione di quasi monopolio del motore Google, che viene utilizzato dalla stragande maggioranza degli utenti. Non resta quindi che sperare nella crescita della consapevolezza e maturità degli utenti.
9) Il deep web
La struttura del web comprende due grandi componenti:
- surface web
- deep web
Il surface web (web di superficie) è la parte più piccola e visibile del web. Contiene tutte le pagine e le risorse che sono indicizzate dai motori di ricerca come Google, e possono essere accedute liberamente da tutti gli utenti.
Il deep web invece comprende tutti i contenuti presenti su internet ma non indicizzati, e quindi non accessibili liberamente con i motori di ricerca classici. Le risorse del deep web possono essere accedute solo conoscendo i relativi URL o tramite le opportuni credenziali di autorizzazione.
La struttura del web è ben rappresentata dalla metafora dell’iceberg: gli utenti comuni vedono la punta dell’iceberg (il surface web), mentre la parte sommersa (il deep web) è accessibile sono mediante procedure speciali. Secondo diverse stime le dimensioni del deep web sono oltre il \(90 \text{%}\) del web totale.
Una parte importante del deep web è costituita da reti intranet aziendali e da database privati, per accedere ai quali è necessario registrarsi e utilizzare delle credenziali. Un esempio importante sono i servizi di home-banking.
Il contenuto del deep web è generalmente più sicuro, grazie anche alla presenza di firewall, e anche la qualità delle informazioni è più elevata.
In genere si può accedere a molti contenuti del deep web tramite lo stesso browser utilizzato per il surface web. Normalmente sono necessari dei passi aggiuntivi, come fornire le credenziali di accesso e altre informazioni.
10) Il dark web
Il dark web è una piccola porzione del deep web. Nella metafora dell’iceberg è la parte più profonda, ed è costituita in gran parte da contenuti illegali e pericolosi. Entrare nel dark web può essere rischioso. Si può essere vittima di truffe, ricatti, violenze, minacce, ecc. da parte di altri soggetti. Inoltre può essere utilizzato da organizzazioni criminali e terroristiche per attività illegali:
- vendita di armi e droghe
- estorsioni, minacce, omicidi
- sequestri di persone
- pedofilia e pornografia
Accesso al dark web
Una differenza fondamentale tra il deep web e il dark web è rappresentata dalla modalità di accesso. Abbiamo visto che normalmente si può accedere al deep web con i normali browser, mediante le opportune credenziali e autorizzazioni.
Invece per accedere al dark web è necessario utilizzare dei programmi appositi che permettono di collegarsi in modo privato e anonimo.
I siti sul dark web hanno in genere l’estensione “.onion” e non è possibile accedere con i browser tradizionali. Un programma molto utilizzato per accedere al dark web è il browser Tor (The Onion Router), il quale mediante dei server dedicati permette di navigare senza essere tracciati e crittografa il traffico sulla rete internet. Per avare maggiore garanzie per l’anonimato è utile utilizzare una VPN.
In teoria non è illegale navigare nel dark web, se non si compiono atti illeciti. Tuttavia può essere comunque molto pericoloso.
Conclusione
I motori di ricerca sul web hanno conosciuto un grandissimo sviluppo, grazie all’espansione della rete internet e alla disponibilità di computer sempre più potenti e performanti. Ormai sono una necessità indispensabile nei vari settori di attività della società attuale. Sono tuttora in continua evoluzione, grazie agli instancabili progressi della scienza e della tecnologia. Tra gli sviluppi più importanti in questo campo ricordiamo:
- utilizzo di metodi dell’intelligenza artificiale
- migliore comprensione del linguaggio naturale e anticipazione delle intenzioni dell’utente
- miglioramento della ricerca vocale
- integrazione della realtà aumentata
- protezione della privacy e neutralità dell’informazione
In articoli successivi descriveremo in dettaglio la matematica utilizzata nei motori di ricerca e in particolare l’algoritmo PageRank di Google.
Bibliografia
[1]Amy N. Langville, Carl D. Meyer – Google’s PageRank and Beyond: The Science of Search Engine Rankings (Princeton University Press)
[2]Enge, Spencer – The Art of SEO: Mastering Search Engine Optimization (O’Reilly Media)
[3]Ceri, Bozzon, Brambilla – Web Information Retrieval (Springer)

0 commenti